
Index trong SEO được thực hiện như thế nào?
Mục lục
- Index SEO là gì?
- Trước khi index, công cụ tìm kiếm phải phát hiện và thu thập URL
- Google xử lý nội dung như thế nào trong quá trình indexing?
- Google không chỉ lưu URL mà còn phải xác định nội dung đại diện
- Khi nào thông tin của trang được lưu vào Google index?
- Điều kiện kỹ thuật cần có không đồng nghĩa với bảo đảm được index
- Robots.txt, noindex và canonical tác động ở những điểm khác nhau
- Được index không có nghĩa chắc chắn có thứ hạng
- Cách hiểu trạng thái index khi kiểm tra SEO
- Ý nghĩa của Index SEO đối với việc tổ chức website
Index SEO là quá trình công cụ tìm kiếm xử lý nội dung đã thu thập, xác định phiên bản đại diện và lưu thông tin phù hợp vào chỉ mục. Hiểu cơ chế này giúp phân biệt rõ crawling, indexing và khả năng xuất hiện trên kết quả tìm kiếm.
Index trong SEO có thể hiểu là giai đoạn công cụ tìm kiếm xử lý, phân tích và lưu trữ thông tin của tài nguyên web vào chỉ mục để thông tin đó có thể được sử dụng khi hệ thống phục vụ kết quả tìm kiếm. Với Google, indexing diễn ra sau quá trình phát hiện và thu thập URL, nhưng một URL được crawl không đồng nghĩa chắc chắn sẽ được index.
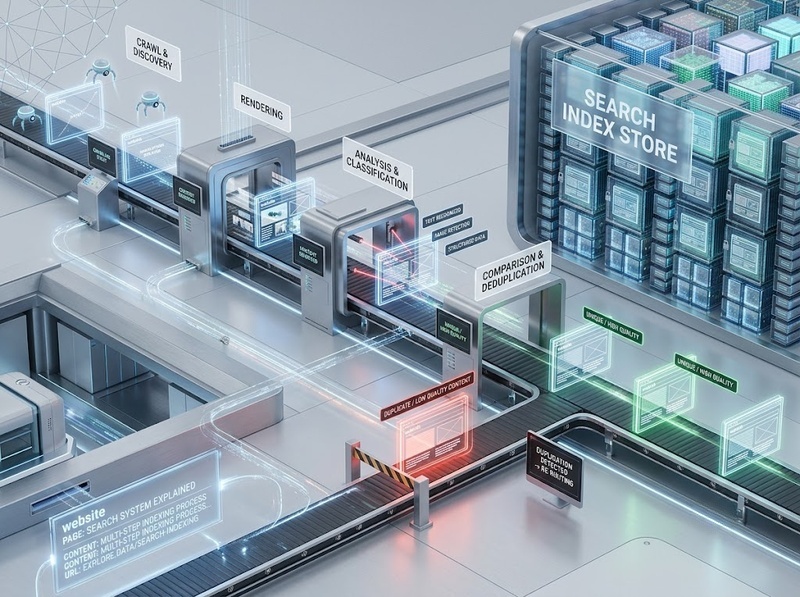
Điểm quan trọng là nhìn index như một quá trình xử lý thông tin, không đơn thuần là trạng thái “URL đã có trên Google”. Trong quá trình này, Google phải hiểu nội dung của trang, xử lý những tín hiệu liên quan, nhận diện các trang giống hoặc gần giống nhau, lựa chọn URL đại diện và quyết định thông tin nào phù hợp để lưu vào Google index.
Index SEO là gì?
Trong ngữ cảnh SEO, “index” thường được dùng để chỉ việc một trang đã được công cụ tìm kiếm đưa vào chỉ mục. Tuy nhiên, xét về cơ chế, indexing rộng hơn một thao tác “thêm URL vào cơ sở dữ liệu”.
Google mô tả Search theo ba giai đoạn chính: crawling, indexing và serving search results. Crawling là quá trình Google tải nội dung từ các URL đã phát hiện; indexing là quá trình phân tích nội dung và lưu thông tin vào Google index; serving là giai đoạn tìm kiếm trong chỉ mục để lựa chọn kết quả phù hợp với truy vấn của người dùng.
Vì vậy, có thể hình dung chuỗi xử lý cơ bản như sau:
Phát hiện URL → Crawl → Render → Phân tích nội dung → Xử lý trùng lặp và canonical → Lưu thông tin vào index → Có khả năng được sử dụng khi phục vụ kết quả tìm kiếm
Cách nhìn này giúp tránh một nhầm lẫn phổ biến: crawl không phải index, và index cũng không phải ranking.
Một trang có thể đã được Googlebot crawl nhưng cuối cùng không được đưa vào index. Ngược lại, một trang đã được index cũng chưa chắc xuất hiện cho một truy vấn cụ thể, bởi việc phục vụ và xếp hạng kết quả còn phụ thuộc vào mức độ liên quan, chất lượng và nhiều tín hiệu khác.
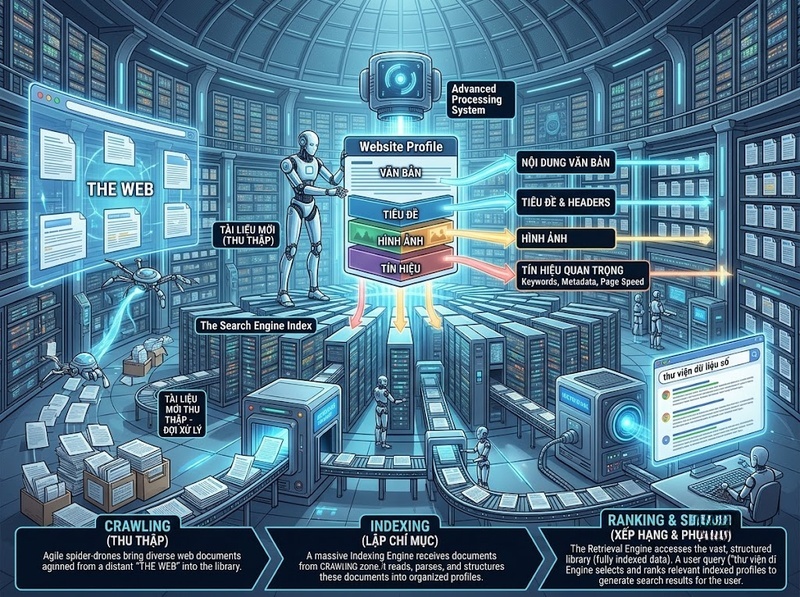
Trước khi index, công cụ tìm kiếm phải phát hiện và thu thập URL
Indexing không bắt đầu từ một trang mà Google hoàn toàn chưa biết đến. Trước đó, công cụ tìm kiếm cần phát hiện URL và có khả năng truy cập nội dung.
Google có thể biết một URL mới thông qua liên kết từ những trang đã biết hoặc thông qua sitemap mà website cung cấp. Sau khi phát hiện URL, Googlebot có thể truy cập URL đó để tải nội dung.
Sitemap vì thế hỗ trợ discovery và crawling, nhưng việc URL có mặt trong sitemap không tạo ra quyền được index. Google nói rõ rằng sitemap có thể giúp hệ thống biết đến website hoặc URL nhưng không bảo đảm indexing.
Ở mức kỹ thuật tối thiểu, một trang muốn đủ điều kiện được Google lập chỉ mục cần cho phép Googlebot truy cập, trả về trạng thái HTTP thành công và có nội dung có thể lập chỉ mục. Tuy nhiên, đáp ứng các yêu cầu đó vẫn không đồng nghĩa Google bắt buộc phải index trang.
Điều này tạo ra một ranh giới quan trọng:
Khả năng crawl là điều kiện đầu vào của quá trình, không phải bằng chứng rằng quá trình index đã hoàn tất.
Google xử lý nội dung như thế nào trong quá trình indexing?
Sau khi crawl một trang, Google bắt đầu phân tích để xác định trang chứa nội dung gì. Theo tài liệu của Google Search Central, indexing bao gồm việc xử lý và phân tích nội dung văn bản cùng những thành phần quan trọng như phần tử
, thuộc tính alt, hình ảnh, video và các dữ liệu liên quan khác.
Đây là điểm khiến “index” khác về bản chất với “crawl”.
Crawl chủ yếu trả lời câu hỏi:
Google có lấy được tài nguyên này không?
Indexing phải tiến xa hơn:
Google xử lý và hiểu tài nguyên vừa lấy được như thế nào, phiên bản nào đại diện cho nội dung và thông tin nào có thể được lưu vào chỉ mục?
Rendering có thể nằm giữa crawling và việc hiểu nội dung
Với những trang phụ thuộc vào JavaScript, HTML ban đầu mà Googlebot nhận được có thể chưa chứa toàn bộ nội dung người dùng nhìn thấy. Google có thể cần render trang và thực thi JavaScript trước khi có được HTML đã render dùng cho việc xử lý tiếp theo.
Điều này có ý nghĩa thực tế với SEO kỹ thuật: nội dung hiển thị bình thường trên trình duyệt của người dùng chưa đủ để kết luận Google chắc chắn nhận được nội dung theo cùng một cách.
Nếu phần nội dung quan trọng chỉ được tạo sau khi JavaScript chạy, khả năng Google render và nhìn thấy phần đó trở thành một mắt xích của quá trình xử lý.
Google hiện vẫn khuyến nghị các giải pháp như server-side rendering, static rendering hoặc hydration thay vì xem dynamic rendering là giải pháp dài hạn cho các vấn đề JavaScript SEO.
Google không chỉ lưu URL mà còn phải xác định nội dung đại diện
Một bước đặc biệt quan trọng của indexing là canonicalization.
Internet có thể tồn tại nhiều URL chứa cùng hoặc gần như cùng một nội dung. Chẳng hạn, các biến thể HTTP/HTTPS, URL có tham số hoặc những URL được tạo bởi chức năng lọc và sắp xếp có thể dẫn đến nội dung tương tự nhau.
Google không nhất thiết coi tất cả những URL đó là các tài liệu độc lập.
Trong quá trình indexing, Google xác định nội dung chính của trang. Nếu nhiều trang có nội dung giống hoặc rất giống nhau, hệ thống có thể nhóm chúng thành một cluster và lựa chọn URL đại diện — canonical URL.
Vì vậy, một tình huống như:
Google đã crawl URL A → Google hiểu nội dung URL A → Google nhận thấy A gần như trùng với B → Google chọn B làm canonical
không mâu thuẫn với cơ chế indexing.
URL A đã được xử lý, nhưng điều đó không có nghĩa A phải trở thành phiên bản độc lập xuất hiện trong kết quả tìm kiếm.
Website có thể cung cấp các tín hiệu giúp Google hiểu URL canonical mong muốn. Redirect và rel="canonical" là những tín hiệu mạnh, trong khi việc đưa URL vào sitemap là tín hiệu yếu hơn. Tuy nhiên, đây vẫn là tín hiệu; Google có thể lựa chọn canonical khác với URL mà website khai báo.
Khi nào thông tin của trang được lưu vào Google index?
Sau khi nội dung được xử lý và canonical được xác định, thông tin về canonical page và cluster của nó có thể được lưu vào Google index — cơ sở dữ liệu lớn mà Google sử dụng trong quá trình phục vụ kết quả tìm kiếm.
Từ “có thể” ở đây rất quan trọng.
Google không bảo đảm mọi trang được crawl hoặc xử lý đều được index. Các vấn đề liên quan đến chất lượng nội dung, robots meta rules hoặc thiết kế website có thể ảnh hưởng đến indexing.
Do đó, không nên mô hình hóa indexing thành:
Googlebot crawl thành công = URL chắc chắn được index
Mô hình phù hợp hơn là:
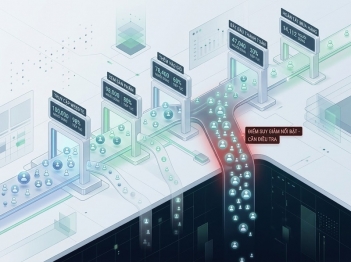
Discovery → Crawl thành công → Nội dung có thể được xử lý/render → Phân tích → Đánh giá và canonicalization → Quyết định indexing
Ngay cả với website lớn, crawl và index vẫn là hai tập hợp khác nhau. Tài liệu về crawl budget của Google cũng nêu rõ rằng không phải mọi trang được crawl đều nhất thiết được index; sau crawling, trang còn phải được đánh giá, hợp nhất và xem xét mức độ phù hợp đối với index.
Điều kiện kỹ thuật cần có không đồng nghĩa với bảo đảm được index
Google đưa ra ba yêu cầu kỹ thuật tối thiểu để một trang đủ điều kiện được index:
1. Googlebot không bị chặn
2. Trang hoạt động và trả về HTTP 200
3. Trang có nội dung có thể lập chỉ mục
Tuy nhiên, chính Google nhấn mạnh rằng đáp ứng ba yêu cầu này không bảo đảm trang sẽ được index.
Sự khác biệt giữa eligible for indexing và guaranteed indexing rất quan trọng khi chẩn đoán SEO.
Ví dụ, việc một URL trả về 200 OK chỉ chứng minh máy chủ đã phản hồi thành công cho yêu cầu đó. Nó không chứng minh rằng Google đã đánh giá URL đủ phù hợp để lưu như một tài liệu độc lập trong index.
Tương tự, submit sitemap hay gửi yêu cầu index không nên được hiểu như một lệnh buộc Google phải đưa URL vào cơ sở dữ liệu. Google cho biết không thể bảo đảm một URL sẽ được crawl hoặc index vào thời điểm cụ thể, và sitemap cũng không bảo đảm indexing.
Robots.txt, noindex và canonical tác động ở những điểm khác nhau
Ba khái niệm này thường bị gom chung thành “công cụ kiểm soát index”, nhưng chúng không thực hiện cùng một nhiệm vụ.
robots.txt chủ yếu kiểm soát khả năng crawler truy cập tài nguyên. Nếu chặn Googlebot bằng robots.txt, Google không thể crawl nội dung theo cách thông thường. Tuy nhiên, Google lưu ý rằng URL bị robots.txt chặn vẫn có khả năng xuất hiện trong kết quả tìm kiếm mà không có nội dung được crawl. Vì vậy, robots.txt không phải công cụ phù hợp nếu mục tiêu chính là yêu cầu Google không index trang.
noindex trực tiếp đưa ra chỉ thị không lập chỉ mục. Để Google nhìn thấy chỉ thị này, crawler cần có khả năng truy cập trang.
canonical lại giải quyết câu hỏi khác: khi tồn tại nhiều URL trùng hoặc gần trùng, URL nào nên được xem là phiên bản đại diện. Canonicalization vì vậy không đồng nghĩa với noindex.
Hiểu đúng vai trò của ba cơ chế này giúp tránh một lỗi logic phổ biến: sử dụng một công cụ kiểm soát crawling để giải quyết một vấn đề thực chất thuộc indexing hoặc canonicalization.
Được index không có nghĩa chắc chắn có thứ hạng
Index là điều kiện để thông tin của trang có thể được hệ thống tìm kiếm sử dụng, nhưng indexing và ranking là hai quá trình khác nhau.
Khi người dùng nhập truy vấn, Google tìm trong index những trang phù hợp và sử dụng các hệ thống xếp hạng để xác định kết quả nào hữu ích và liên quan nhất. Google cho biết các hệ thống ranking xem xét nhiều yếu tố và tín hiệu trên lượng rất lớn nội dung trong Search index.
Vì thế có thể phân biệt:
Crawled: Googlebot đã thu thập URL hoặc tài nguyên
Indexed: Google đã xử lý và lưu thông tin phù hợp trong chỉ mục
Ranking/Serving: Google lựa chọn nội dung từ index để phục vụ một truy vấn cụ thể và xác định vị trí tương đối của kết quả
Một URL được Search Console xác nhận là indexed nhưng không xuất hiện khi bạn thử một truy vấn nào đó không nhất thiết là lỗi indexing. Google nêu các khả năng như nội dung không đủ liên quan tới truy vấn hoặc chất lượng không đủ để được lựa chọn cho kết quả đó.
Cách hiểu trạng thái index khi kiểm tra SEO
Khi một URL không xuất hiện trên Google, câu hỏi hữu ích không chỉ là “đã index chưa?” mà nên lần theo chuỗi xử lý.
Trước hết cần xác định Google có biết URL hay chưa. Sau đó kiểm tra Googlebot có truy cập được URL, máy chủ có trả về phản hồi phù hợp và nội dung quan trọng có xuất hiện sau rendering hay không. Tiếp theo mới xem xét các chỉ thị index, canonical và khả năng URL bị xem là bản trùng lặp.
Google Search Console cung cấp URL Inspection để kiểm tra một URL cụ thể; Page Indexing report và Crawl Stats có thể hỗ trợ quan sát những vấn đề ở quy mô website.
Cách chẩn đoán này phản ánh đúng bản chất của hệ thống:
Không index là kết quả cuối của nhiều khả năng khác nhau, chứ không phải một lỗi duy nhất có một cách sửa duy nhất.
Một URL có thể chưa được phát hiện, chưa được crawl, crawl thất bại, bị ngăn lập chỉ mục, chưa cung cấp nội dung cần thiết sau rendering, bị hợp nhất vào canonical khác hoặc đơn giản chưa được Google lựa chọn để đưa vào index.
Ý nghĩa của Index SEO đối với việc tổ chức website
Hiểu index theo quá trình xử lý và lưu trữ giúp SEO chuyển trọng tâm từ “ép Google index URL” sang tạo điều kiện để công cụ tìm kiếm phát hiện, truy cập, hiểu và xác định đúng phiên bản nội dung cần lưu.
Điều đó có nghĩa website cần duy trì đường dẫn khám phá nội dung rõ ràng, phản hồi máy chủ phù hợp, nội dung mà crawler có thể xử lý, các chỉ thị robots nhất quán và tín hiệu canonical không mâu thuẫn.
Đối với các URL trùng lặp, việc hợp nhất tín hiệu cũng có giá trị vận hành. Google khuyến nghị liên kết nội bộ nhất quán tới canonical URL; redirects, rel="canonical" và sitemap có thể cung cấp những mức tín hiệu khác nhau để thể hiện phiên bản ưu tiên.
Mục tiêu vì thế không phải làm cho mọi URL kỹ thuật của website đều được index. Điều cần hướng tới là để những tài nguyên thực sự cần xuất hiện trong Search có thể được Google khám phá, xử lý và nhận diện đúng vai trò.
Index SEO về bản chất là một mắt xích trong hệ thống xử lý thông tin của công cụ tìm kiếm. Với Google, trang được phát hiện và crawl trước, có thể được render, sau đó nội dung và các tín hiệu quan trọng được phân tích; những trang tương tự có thể được gom nhóm để lựa chọn canonical, rồi thông tin phù hợp mới có thể được lưu vào Google index.
Vì vậy, crawl thành công không bảo đảm index, index không bảo đảm ranking và việc gửi URL cũng không tạo ra quyền được lập chỉ mục. Khi phân tích một vấn đề index, cần xác định URL đang dừng ở mắt xích nào của chuỗi discovery → crawling → rendering → processing → canonicalization → indexing, thay vì xem “index” như một thao tác đơn lẻ.
Hỏi đáp về Index SEO
Google crawl một URL rồi thì URL đó có chắc chắn được index không?
Không. Google xác nhận rằng không phải mọi trang được crawl đều được index. Sau crawling, nội dung còn được xử lý, đánh giá và có thể được hợp nhất với các phiên bản trùng lặp trước khi hệ thống quyết định thông tin nào phù hợp với index.
Sitemap có làm URL được index nhanh hơn và bảo đảm index không?
Sitemap giúp Google biết đến các URL mới hoặc được cập nhật, nhưng không bảo đảm URL sẽ được index. Nó nên được xem là một cơ chế hỗ trợ discovery và cung cấp tín hiệu về URL, không phải lệnh bắt buộc Google đưa trang vào chỉ mục.
URL canonical có phải là URL duy nhất được Google crawl không?
Không. Google có thể crawl nhiều URL trong một nhóm nội dung tương tự. Sau khi nhận diện các trang trùng hoặc gần trùng, hệ thống lựa chọn một URL đại diện làm canonical; canonical thường được crawl thường xuyên hơn, còn các bản trùng có thể được crawl ít hơn.
Trang đã index nhưng không tìm thấy trên Google có bất thường không?
Không nhất thiết. Một trang có thể tồn tại trong index nhưng không được lựa chọn cho truy vấn bạn đang kiểm tra vì mức độ liên quan, chất lượng hoặc các yếu tố phục vụ kết quả khác. Do đó, không xuất hiện cho một truy vấn cụ thể chưa đủ để kết luận URL chưa được index.

GỬI Ý KIẾN BÌNH LUẬN
