Machine Learning học từ dữ liệu như thế nào?
Mục lục
- Machine Learning biến dữ liệu thành mô hình ra sao?
- Quá trình huấn luyện giúp mô hình “học” như thế nào?
- Dữ liệu quyết định mô hình có thể học được điều gì?
- Dự đoán khác gì với quá trình huấn luyện?
- Vì sao loss giảm chưa chắc mô hình đã học tốt?
- Mô hình được cải thiện bằng cách nào?
- Hiểu đúng bản chất của việc máy “học”
Machine Learning là cách hệ thống học các quy luật hữu ích từ dữ liệu thay vì phải được lập trình sẵn mọi quy tắc. Quá trình này diễn ra qua việc biểu diễn dữ liệu, tạo dự đoán, đo sai số, điều chỉnh tham số và kiểm tra khả năng dự đoán trên dữ liệu chưa từng thấy.
Machine Learning có thể được hiểu như một quá trình biến kinh nghiệm chứa trong dữ liệu thành một mô hình có khả năng đưa ra dự đoán hoặc nhận diện cấu trúc. Điểm quan trọng không nằm ở việc máy tính “ghi nhớ” thật nhiều dữ liệu, mà ở việc nó tìm được những quan hệ đủ ổn định để tiếp tục hoạt động trên dữ liệu mới.
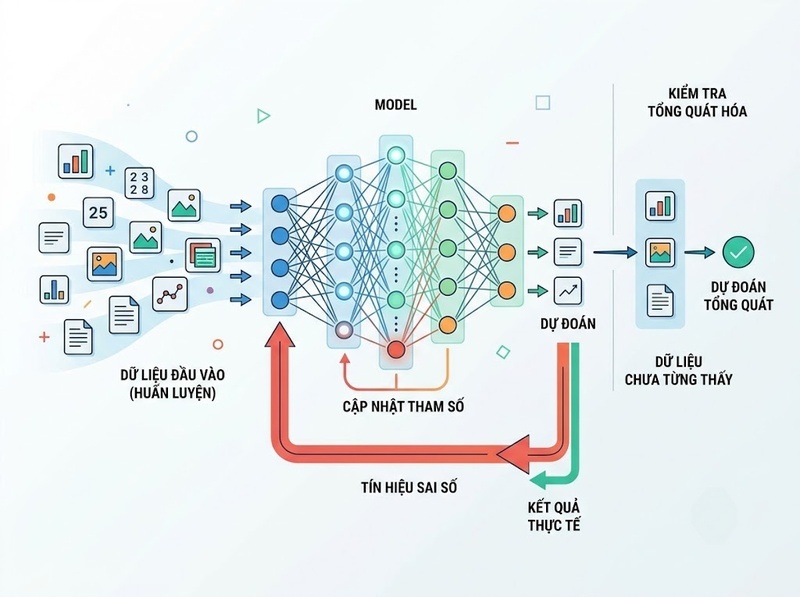
Trong một bài toán học có giám sát điển hình, quá trình này có thể hình dung thành một vòng lặp:
Dữ liệu → Mô hình → Dự đoán → Đo sai số → Điều chỉnh → Dự đoán lại
Sau nhiều lần điều chỉnh, mô hình có thể ngày càng phù hợp với dữ liệu huấn luyện. Nhưng học tốt không đồng nghĩa với việc chỉ đạt sai số thấp trên những ví dụ đã thấy. Mục tiêu quan trọng hơn là generalization: mô hình vẫn đưa ra dự đoán hữu ích khi gặp dữ liệu chưa xuất hiện trong quá trình huấn luyện.
Machine Learning biến dữ liệu thành mô hình ra sao?
Machine Learning là một phương pháp xây dựng hệ thống trong đó hành vi của mô hình được xác định một phần bằng dữ liệu. Thay vì con người phải viết đầy đủ các quy tắc kiểu “nếu A thì B”, thuật toán học tìm các tham số hoặc cấu trúc giúp mô hình mô tả quan hệ tồn tại trong các ví dụ.
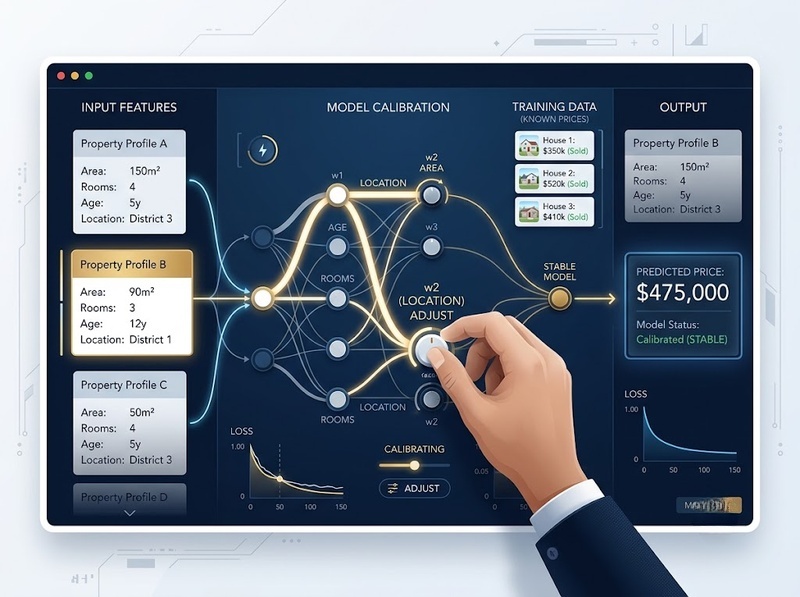
Giả sử cần dự đoán giá một căn nhà. Mỗi căn nhà có thể được mô tả bằng những đặc trưng như diện tích, số phòng, tuổi công trình hoặc vị trí. Trong supervised learning, dữ liệu còn có giá bán thực tế đóng vai trò đầu ra mục tiêu.
Một mô hình đơn giản có thể biểu diễn dự đoán dưới dạng:
ŷ = w₁x₁ w₂x₂ ... wₙxₙ b
Trong đó, x là các đặc trưng đầu vào, w là các trọng số, b là hệ số chệch và ŷ là giá trị mô hình dự đoán.
Ban đầu, các tham số w và b chưa biểu diễn tốt quan hệ giữa đặc trưng và giá nhà. Huấn luyện chính là quá trình tìm những giá trị tham số thích hợp hơn.
Điều này làm rõ một khác biệt quan trọng: dữ liệu không tự động biến thành tri thức. Cần có một mô hình xác định cách kết hợp dữ liệu và một quy trình học xác định cách thay đổi mô hình dựa trên kết quả quan sát được.
Quá trình huấn luyện giúp mô hình “học” như thế nào?
Trong supervised learning, một vòng huấn luyện có thể được hiểu qua bốn hoạt động liên tiếp: đưa dữ liệu vào mô hình, tạo dự đoán, đo mức sai và điều chỉnh mô hình.
Giả sử một căn nhà thực tế được bán với giá 3 tỷ đồng nhưng mô hình dự đoán 2,4 tỷ đồng. Khoảng cách giữa dự đoán và giá trị thực cho biết mô hình đang mắc sai số.
Tuy nhiên, thuật toán không chỉ nhìn vào một câu mô tả như “dự đoán sai 600 triệu đồng”. Sai số cần được biểu diễn bằng một loss function — hàm toán học chuyển mức độ sai của dự đoán thành giá trị có thể tối ưu.
Với bài toán hồi quy, một lựa chọn phổ biến là Mean Squared Error:
MSE = (1/n) Σ(yᵢ − ŷᵢ)²
Nếu dự đoán gần giá trị thực hơn, loss thường giảm. Vì vậy, quá trình huấn luyện có thể được diễn đạt thành một bài toán tối ưu:
Tìm các tham số làm loss nhỏ hơn.
Một phương pháp tối ưu phổ biến là gradient descent. Gradient cho biết loss thay đổi theo hướng nào khi tham số thay đổi. Thuật toán sử dụng thông tin đó để cập nhật tham số theo hướng có khả năng giảm loss.
Ở dạng khái quát:
w mới = w cũ − learning rate × gradient
Learning rate quyết định độ lớn của mỗi bước cập nhật. Nếu quá lớn, quá trình tối ưu có thể vượt qua vùng tốt; nếu quá nhỏ, việc hội tụ có thể chậm.
Vòng lặp được thực hiện nhiều lần:
1. Đọc một phần dữ liệu huấn luyện
2. Tạo dự đoán bằng tham số hiện tại
3. Tính loss
4. Tính hướng điều chỉnh
5. Cập nhật tham số
6. Lặp lại với dữ liệu tiếp theo
Sau nhiều vòng, mô hình không nhất thiết nhớ từng ví dụ riêng lẻ. Điều mà quá trình tối ưu hướng tới là một tập tham số biểu diễn những quan hệ có ích cho nhiệm vụ dự đoán.
Dữ liệu quyết định mô hình có thể học được điều gì?
Thuật toán chỉ có thể học từ tín hiệu có mặt trong dữ liệu và cách dữ liệu được biểu diễn.
Nếu muốn dự đoán giá nhà nhưng dữ liệu chỉ chứa màu sơn trong khi những yếu tố có sức giải thích lớn như diện tích hoặc vị trí bị thiếu, mô hình bị giới hạn ngay từ đầu. Một thuật toán phức tạp không thể tự phục hồi thông tin quan trọng chưa từng được cung cấp.
Chất lượng dữ liệu cũng ảnh hưởng trực tiếp đến quá trình học. Giá trị bị thiếu, nhãn sai, mẫu dữ liệu không đại diện hoặc đặc trưng được biểu diễn không phù hợp đều có thể khiến mô hình học những quan hệ không mong muốn.
Trong supervised learning, label đặc biệt quan trọng vì nó cung cấp mục tiêu mà dự đoán được so sánh với. Nếu đầu vào là ảnh và label cho biết ảnh thuộc lớp “mèo” hay “chó”, quá trình tối ưu có thể điều chỉnh mô hình dựa trên chênh lệch giữa lớp dự đoán và lớp thực.
Nhưng không phải Machine Learning nào cũng học theo cách này.
Trong unsupervised learning, dữ liệu không nhất thiết có nhãn mục tiêu. Thuật toán có thể tìm cấu trúc, nhóm hoặc quan hệ nội tại trong dữ liệu. Trong reinforcement learning, tín hiệu học lại đến từ reward liên quan đến hành động của tác nhân.
Vì vậy, “học từ dữ liệu” không có nghĩa tất cả mô hình đều dùng cùng một cơ chế loss giữa dự đoán và nhãn. Cơ chế cụ thể phụ thuộc vào loại bài toán học.
Dự đoán khác gì với quá trình huấn luyện?
Huấn luyện và dự đoán là hai giai đoạn có vai trò khác nhau.
Training là giai đoạn mô hình thay đổi các tham số dựa trên dữ liệu. Inference là giai đoạn sử dụng các tham số đã học để xử lý một đầu vào mới.
Quay lại ví dụ giá nhà: trong lúc huấn luyện, hệ thống có thể sử dụng hàng nghìn căn nhà có giá bán đã biết để điều chỉnh trọng số. Sau khi huấn luyện, một căn nhà mới được đưa vào với diện tích, số phòng và các đặc trưng liên quan. Mô hình áp dụng những tham số đã học để tạo giá dự đoán.
Trong inference thông thường, mô hình không tự động thay đổi trọng số chỉ vì vừa nhận thêm một đầu vào. Nó sử dụng trạng thái đã học để suy luận.
Sự phân biệt này giúp tránh một hiểu lầm phổ biến rằng hệ thống Machine Learning “học liên tục” từ mọi dữ liệu mà nó tiếp xúc. Một mô hình chỉ cập nhật khi có một cơ chế huấn luyện hoặc cập nhật được thiết kế để thực hiện việc đó.
Vì sao loss giảm chưa chắc mô hình đã học tốt?
Nếu chỉ đánh giá mô hình trên dữ liệu đã dùng để huấn luyện, một vấn đề xuất hiện: mô hình có thể rất giỏi với những ví dụ đã thấy nhưng hoạt động kém trên dữ liệu mới.
Hiện tượng này được gọi là overfitting.
Hãy tưởng tượng một học sinh ghi nhớ đáp án của toàn bộ bộ đề luyện tập. Nếu bài thi thật lặp lại đúng các câu đó, kết quả có thể rất cao. Nhưng nếu câu hỏi thay đổi, việc ghi nhớ không đảm bảo người học giải được vấn đề.
Machine Learning cũng tương tự. Training loss rất thấp chỉ cho thấy mô hình phù hợp tốt với training set; nó chưa chứng minh mô hình đã nắm được một quan hệ có thể áp dụng rộng hơn.
Vì vậy, dữ liệu thường được tách thành các tập có chức năng khác nhau:
· Training set dùng để học tham số
· Validation set dùng để đánh giá trong quá trình phát triển và lựa chọn mô hình
· Test set dùng để đánh giá cuối cùng trên dữ liệu không được dùng để học tham số
Việc học tham số và kiểm tra trên cùng dữ liệu là một sai lầm phương pháp luận: một mô hình có thể đạt kết quả rất tốt bằng cách phù hợp quá mức với những mẫu đã thấy mà không dự đoán hữu ích trên mẫu mới.
Khái niệm trung tâm ở đây là generalization — khả năng mô hình đưa ra dự đoán đúng hoặc hữu ích trên dữ liệu chưa từng gặp.
Do đó, câu hỏi quan trọng không chỉ là:
“Training loss đã giảm bao nhiêu?”
Mà còn là:
“Hiệu năng trên dữ liệu chưa thấy có cải thiện tương ứng không?”
Mô hình được cải thiện bằng cách nào?
Cải thiện mô hình không đơn giản là huấn luyện lâu hơn.
Nếu mô hình chưa học đủ cấu trúc cần thiết, tăng số vòng huấn luyện có thể giúp loss tiếp tục giảm. Nhưng nếu mô hình đã bắt đầu overfit, tiếp tục tối ưu training loss có thể làm khoảng cách giữa hiệu năng huấn luyện và hiệu năng validation lớn hơn.
Cải thiện vì vậy thường liên quan đến nhiều thành phần của toàn bộ hệ thống học.
Cải thiện dữ liệu
Có thể xử lý dữ liệu thiếu, sửa nhãn không đáng tin cậy, thu thập thêm các ví dụ đại diện hoặc tạo cách biểu diễn đặc trưng phù hợp hơn.
Đây là yếu tố nền tảng bởi mô hình học trực tiếp từ tín hiệu mà dữ liệu cung cấp.
Điều chỉnh mô hình và quá trình tối ưu
Kiến trúc mô hình, learning rate, batch size và các hyperparameter khác có thể ảnh hưởng đến quá trình học.
Mục tiêu không phải tìm cấu hình làm training loss thấp nhất bằng mọi giá, mà tìm cấu hình tạo được hiệu năng tốt trên dữ liệu ngoài tập huấn luyện.
Kiểm soát overfitting
Các kỹ thuật như regularization hoặc early stopping có thể hạn chế việc mô hình bám quá sát những đặc điểm riêng của training set.
Một tín hiệu hữu ích là theo dõi đồng thời training loss và validation loss. Nếu training loss tiếp tục giảm trong khi validation loss bắt đầu tăng, mô hình có thể đang học quá mức những đặc điểm riêng của dữ liệu huấn luyện.
Đánh giá lại trên dữ liệu độc lập
Sau khi quá trình phát triển hoàn tất, test set cung cấp một phép kiểm tra độc lập hơn về khả năng generalization.
Điều này tạo nên một chu trình cải thiện có nguyên tắc:
Huấn luyện → Validation → Phát hiện vấn đề → Điều chỉnh → Huấn luyện lại → Đánh giá
Mô hình vì thế không “tự trở nên thông minh hơn” một cách vô điều kiện. Chất lượng cuối cùng phụ thuộc đồng thời vào dữ liệu, mục tiêu học, cấu trúc mô hình, thuật toán tối ưu và cách đánh giá.
Hiểu đúng bản chất của việc máy “học”
Từ “học” dễ khiến Machine Learning được hình dung giống quá trình nhận thức của con người. Nhưng ở cấp độ kỹ thuật, cách hiểu hữu ích hơn là: hệ thống đang điều chỉnh một biểu diễn toán học dựa trên tín hiệu từ dữ liệu để cải thiện một mục tiêu xác định.
Trong supervised learning, tín hiệu đó thường xuất hiện dưới dạng chênh lệch giữa dự đoán và giá trị mục tiêu. Loss lượng hóa chênh lệch, thuật toán tối ưu sử dụng loss để cập nhật tham số, và dữ liệu validation/test giúp kiểm tra liệu những tham số đó có còn hữu ích ngoài dữ liệu huấn luyện hay không.
Một mô hình vì thế có thể tạo dự đoán chính xác mà không cần “hiểu” đối tượng theo nghĩa con người hiểu nó.
Điều thực sự cần kiểm tra là quan hệ mà mô hình học được có đủ ổn định để tổng quát hóa hay không. Nếu dữ liệu chứa tương quan ngẫu nhiên, thiên lệch hoặc những tín hiệu chỉ tồn tại trong training set, mô hình cũng có thể học chúng.
Đây là lý do một pipeline Machine Learning tốt không kết thúc khi training loss giảm. Nó chỉ có ý nghĩa khi mô hình chứng minh được khả năng hoạt động trên dữ liệu phù hợp nhưng chưa từng thấy.
Machine Learning học từ dữ liệu bằng cách biến các ví dụ thành tín hiệu để điều chỉnh mô hình. Trong supervised learning, mô hình tạo dự đoán, loss đo mức sai, thuật toán tối ưu cập nhật tham số và quá trình này được lặp lại cho đến khi đạt trạng thái phù hợp.
Nhưng “học được training set” và “học được quy luật có ích” là hai việc khác nhau. Khả năng quan trọng nhất là generalization: mô hình phải áp dụng được những gì đã học lên dữ liệu mới. Vì vậy, dữ liệu, quá trình huấn luyện, validation và test phải được nhìn như các phần của cùng một cơ chế học, thay vì chỉ tập trung vào việc làm cho sai số huấn luyện ngày càng nhỏ.

GỬI Ý KIẾN BÌNH LUẬN
Bài xem nhiều
