
Big Data là gì và được sử dụng như thế nào?
Mục lục
- Big Data không chỉ có nghĩa là dữ liệu có dung lượng lớn
- Volume, Velocity và Variety giải thích bản chất của Big Data
- Big Data được xử lý từ dữ liệu thô đến thông tin như thế nào?
- Big Data được sử dụng để làm gì trong thực tế?
- Kiến trúc Big Data cần khả năng mở rộng thay vì một công cụ duy nhất
- Giá trị của Big Data phụ thuộc vào chất lượng dữ liệu và mục tiêu phân tích
Big Data là các tập dữ liệu có quy mô, tốc độ phát sinh hoặc mức độ đa dạng khiến phương pháp xử lý truyền thống gặp giới hạn. Giá trị của Big Data không nằm ở việc có thật nhiều dữ liệu, mà ở khả năng thu thập, xử lý và phân tích dữ liệu ở quy mô phù hợp để tạo ra thông tin có thể sử dụng.
Big Data thường được hiểu đơn giản là “dữ liệu lớn”, nhưng kích thước chỉ là một phần của vấn đề. Theo cách định nghĩa của NIST, Big Data liên quan đến những tập dữ liệu có các đặc trưng như volume, variety, velocity và/hoặc variability, đến mức cần kiến trúc có khả năng mở rộng để lưu trữ, thao tác và phân tích hiệu quả.
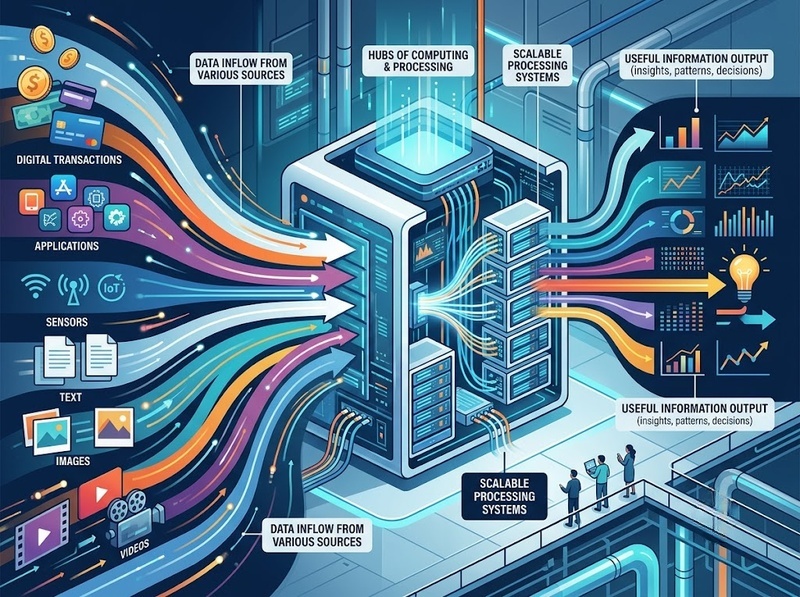
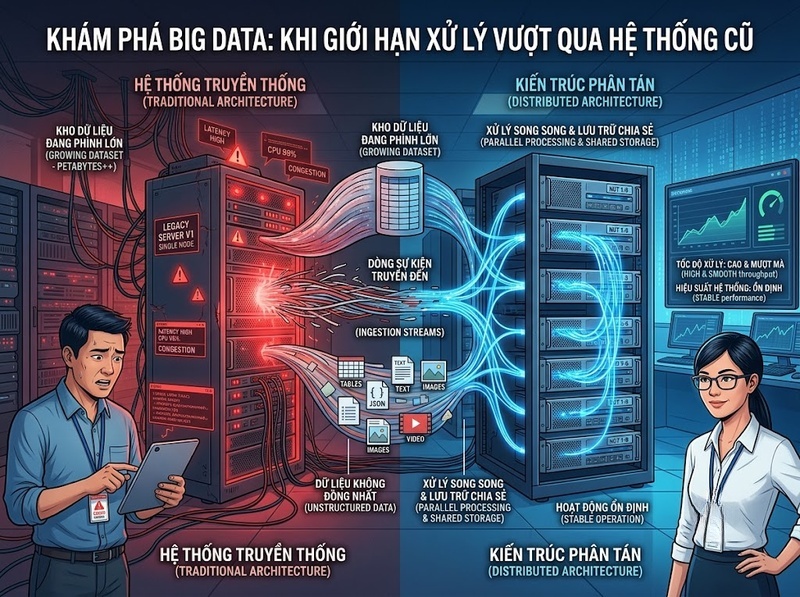
Vì vậy, một tập dữ liệu không tự động trở thành Big Data chỉ vì dung lượng đạt đến một con số nhất định. Điểm quan trọng là mối quan hệ giữa đặc tính dữ liệu và năng lực của hệ thống xử lý. Khi dữ liệu quá lớn, đến quá nhanh hoặc tồn tại dưới quá nhiều dạng khiến kiến trúc thông thường không còn đáp ứng tốt yêu cầu lưu trữ và phân tích, bài toán Big Data bắt đầu xuất hiện.
Trong thực tế, Big Data được sử dụng bằng cách kết nối nhiều công đoạn: thu thập dữ liệu từ các nguồn khác nhau, lưu trữ trên hạ tầng có khả năng mở rộng, xử lý theo lô hoặc theo luồng, phân tích để tìm mẫu và cuối cùng chuyển kết quả thành thông tin phục vụ hoạt động hoặc ra quyết định.
Big Data không chỉ có nghĩa là dữ liệu có dung lượng lớn
“Big” trong Big Data dễ khiến người đọc tập trung hoàn toàn vào số byte được lưu trữ. Cách hiểu này chưa đầy đủ vì không tồn tại một ngưỡng dung lượng duy nhất có thể áp dụng cho mọi hệ thống để xác định dữ liệu có phải Big Data hay không.
Một hệ thống có thể gặp bài toán Big Data do phải xử lý lượng dữ liệu rất lớn. Hệ thống khác lại gặp khó khăn vì hàng loạt sự kiện phải được tiếp nhận liên tục với độ trễ thấp. Trường hợp khác nữa, thách thức nằm ở việc kết hợp bảng giao dịch, văn bản, ảnh, video, dữ liệu cảm biến và các định dạng bán cấu trúc.
NIST nhấn mạnh chính những đặc tính này có thể làm quá tải các cách tiếp cận kỹ thuật truyền thống và tạo ra nhu cầu đối với kiến trúc có khả năng mở rộng.
Do đó, Big Data nên được nhìn như một bài toán về đặc tính dữ liệu kết hợp với khả năng xử lý, thay vì một nhãn được quyết định đơn thuần bởi dung lượng.
Volume, Velocity và Variety giải thích bản chất của Big Data
Ba đặc tính thường được dùng để hình dung Big Data là Volume, Velocity và Variety. Chúng giải thích lần lượt hệ thống phải xử lý bao nhiêu dữ liệu, dữ liệu di chuyển nhanh đến mức nào và dữ liệu tồn tại dưới bao nhiêu dạng khác nhau.
Volume: khối lượng dữ liệu
Volume là quy mô dữ liệu cần lưu trữ và phân tích. Khi khối lượng tăng, một máy đơn lẻ hoặc phương thức xử lý tuần tự có thể không còn đáp ứng được yêu cầu về thời gian, bộ nhớ hoặc khả năng lưu trữ.
Đây là lý do Big Data thường gắn với xử lý phân tán và song song. Thay vì buộc một máy thực hiện toàn bộ công việc, dữ liệu và tác vụ có thể được phân phối trên nhiều tài nguyên tính toán. NIST cũng xác định volume là một động lực tạo ra nhu cầu song song hóa lưu trữ và xử lý.
Velocity: tốc độ dữ liệu
Velocity mô tả tốc độ dữ liệu được tạo ra, truyền đến hệ thống và cần được xử lý.
Nếu doanh nghiệp chỉ tổng hợp giao dịch cuối ngày, xử lý theo lô có thể đáp ứng yêu cầu. Nhưng với dữ liệu cảm biến, sự kiện từ ứng dụng hoặc các hoạt động cần phản ứng nhanh, giá trị của dữ liệu có thể giảm khi kết quả phân tích đến quá muộn.
Bởi vậy, Big Data không chỉ đặt câu hỏi “lưu được bao nhiêu?” mà còn đặt câu hỏi “xử lý kịp hay không?”.
Variety: sự đa dạng của dữ liệu
Dữ liệu truyền thống thường được hình dung dưới dạng bảng với hàng và cột rõ ràng. Big Data có thể đồng thời bao gồm dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc như JSON, văn bản, nhật ký hệ thống, hình ảnh hoặc video.
IBM sử dụng mô hình năm V gồm Volume, Velocity, Variety, Veracity và Value để mô tả rộng hơn những đặc tính của Big Data. Trong đó Veracity liên quan đến độ tin cậy của dữ liệu, còn Value nhấn mạnh khả năng chuyển dữ liệu thành giá trị hữu ích.
Điều này cho thấy dữ liệu nhiều chưa đủ. Dữ liệu còn phải được quản lý, kiểm soát chất lượng và phân tích theo cách tạo ra kết quả có ý nghĩa.
Big Data được xử lý từ dữ liệu thô đến thông tin như thế nào?
Giá trị của Big Data hình thành qua một chuỗi xử lý chứ không xuất hiện ngay khi dữ liệu được thu thập.
Đầu tiên, dữ liệu được tạo ra từ các nguồn như giao dịch, ứng dụng, thiết bị kết nối, hệ thống vận hành hoặc nội dung số. Các nguồn này có thể tạo dữ liệu với cấu trúc và tốc độ hoàn toàn khác nhau.
Tiếp theo, hệ thống tiếp nhận và lưu trữ dữ liệu. Khi quy mô vượt khả năng thuận tiện của một máy hoặc một cơ sở dữ liệu truyền thống, kiến trúc có thể phân phối dữ liệu trên nhiều tài nguyên hoặc sử dụng hạ tầng có khả năng mở rộng.
Sau đó là giai đoạn xử lý. Với dữ liệu không yêu cầu phản hồi ngay, hệ thống có thể xử lý theo lô. Với dữ liệu liên tục và nhạy cảm với thời gian, xử lý luồng có thể phù hợp hơn. Apache Spark là một ví dụ về công cụ phân tích dữ liệu quy mô lớn hỗ trợ các workload như xử lý dữ liệu có cấu trúc, machine learning và stream processing.
Dữ liệu sau khi được làm sạch, kết hợp và biến đổi mới trở thành đầu vào thích hợp cho phân tích. Các phương pháp có thể trải từ thống kê và truy vấn tổng hợp đến machine learning, tùy câu hỏi cần giải quyết.
Luồng cơ bản có thể hình dung là:
Nguồn dữ liệu → Thu thập → Lưu trữ → Xử lý → Phân tích → Thông tin → Hành động
Điểm cuối cùng rất quan trọng. Nếu tổ chức chỉ lưu trữ lượng dữ liệu khổng lồ mà không chuyển nó thành thông tin phục vụ một mục tiêu cụ thể, quy mô dữ liệu tự thân không tạo ra giá trị.
Big Data được sử dụng để làm gì trong thực tế?
Big Data phát huy tác dụng khi một câu hỏi thực tế có thể được giải quyết tốt hơn bằng việc phân tích nhiều dữ liệu, nhiều nguồn dữ liệu hoặc dữ liệu có tốc độ cao.
Trong hoạt động kinh doanh, dữ liệu giao dịch và hành vi có thể được tổng hợp để nhận diện xu hướng sử dụng sản phẩm, phân khúc khách hàng hoặc những mẫu hoạt động khó thấy khi chỉ quan sát từng giao dịch riêng lẻ.
Trong hệ thống số, lượng lớn log và sự kiện có thể được phân tích để theo dõi hoạt động của dịch vụ. Thay vì chỉ kiểm tra một máy hoặc một bản ghi lỗi, tổ chức có thể tìm mẫu trên dữ liệu phát sinh từ nhiều thành phần của hệ thống.
Với dữ liệu cảm biến và thiết bị kết nối, dòng dữ liệu liên tục có thể được xử lý để theo dõi trạng thái và phát hiện những biến động cần chú ý. Trong những trường hợp như vậy, Velocity trở thành yếu tố quan trọng vì một cảnh báo đúng nhưng xuất hiện quá muộn có thể giảm đáng kể giá trị thực tế.
Big Data cũng tạo nền dữ liệu cho các mô hình phân tích và machine learning. NIST lưu ý rằng khả năng xử lý lượng dữ liệu lớn hơn là một trong những yếu tố gắn với sự phát triển của nhiều kỹ thuật machine learning.
Điểm chung của các ứng dụng trên không phải là “càng nhiều dữ liệu càng tốt”. Dữ liệu phải liên quan đến vấn đề cần giải quyết và kết quả phân tích phải có khả năng hỗ trợ một hành động hoặc quyết định cụ thể.
Kiến trúc Big Data cần khả năng mở rộng thay vì một công cụ duy nhất
Một hiểu nhầm phổ biến là xem Big Data như tên của một phần mềm hoặc một loại cơ sở dữ liệu. Thực tế, Big Data là một bài toán dữ liệu có thể cần nhiều thành phần phối hợp với nhau.
NIST xây dựng Big Data Reference Architecture theo hướng kiến trúc, với các vai trò và thành phần chức năng phục vụ quá trình cung cấp, xử lý và tiêu thụ dữ liệu. Điều này phản ánh bản chất của Big Data: vấn đề không được giải quyết chỉ bằng việc chọn một công cụ lưu trữ lớn hơn.
Khả năng mở rộng là nguyên tắc trung tâm. Khi Volume tăng, hệ thống phải có cách mở rộng lưu trữ và tính toán. Khi Velocity tăng, kiến trúc phải đáp ứng tốc độ tiếp nhận và xử lý. Khi Variety tăng, hệ thống phải làm việc được với nhiều kiểu dữ liệu mà không biến quá trình tích hợp thành nút thắt.
Các công nghệ cụ thể chỉ là phương tiện thực hiện những nhiệm vụ này. Ví dụ, Spark được thiết kế như một engine thống nhất cho xử lý dữ liệu quy mô lớn và có thể thực hiện cả batch processing lẫn những workload như streaming, truy vấn tương tác và machine learning.
Vì thế, câu hỏi quan trọng khi xây dựng hệ thống không phải “công nghệ Big Data nào tốt nhất?” mà là đặc tính nào của dữ liệu đang vượt quá khả năng của kiến trúc hiện tại và hệ thống cần mở rộng ở đâu?
Giá trị của Big Data phụ thuộc vào chất lượng dữ liệu và mục tiêu phân tích
Khả năng lưu trữ hàng terabyte hay petabyte dữ liệu không đồng nghĩa với việc tổ chức sẽ tự động có thông tin tốt hơn.
Nếu dữ liệu thiếu chính xác, chứa nhiều bản ghi trùng lặp, không đại diện cho vấn đề đang nghiên cứu hoặc được thu thập mà không gắn với câu hỏi cụ thể, tăng Volume có thể chỉ làm tăng chi phí lưu trữ và xử lý.
Đây là lý do Veracity và Value thường được bổ sung bên cạnh ba đặc tính Volume, Velocity và Variety. Veracity đặt câu hỏi dữ liệu đáng tin cậy đến đâu; Value đặt câu hỏi kết quả thu được từ dữ liệu có thực sự hữu ích hay không.
Một hệ thống Big Data hiệu quả vì thế cần cân bằng nhiều yếu tố. Thu thập thêm dữ liệu có thể tăng khả năng phát hiện mẫu nhưng cũng làm tăng yêu cầu về lưu trữ, tính toán, quản trị và kiểm soát chất lượng. Xử lý dữ liệu nhanh hơn có thể tạo thông tin kịp thời hơn, nhưng không phải mọi bài toán đều cần phân tích thời gian thực.
Ranh giới quan trọng nằm ở nhu cầu thực tế: Big Data có ý nghĩa khi đặc tính dữ liệu đòi hỏi khả năng xử lý có thể mở rộng và việc phân tích dữ liệu đó tạo ra thông tin hữu ích hơn cho mục tiêu đang theo đuổi.
Big Data có thể được hiểu là những tập dữ liệu mà quy mô, tốc độ, sự đa dạng hoặc các đặc tính liên quan tạo ra yêu cầu vượt quá cách xử lý truyền thống và cần kiến trúc có khả năng mở rộng. Volume giải thích áp lực về khối lượng, Velocity giải thích áp lực về thời gian, còn Variety giải thích độ phức tạp khi phải kết hợp nhiều loại dữ liệu.
Trong sử dụng thực tế, Big Data không dừng ở việc thu thập và lưu trữ. Dữ liệu phải đi qua quá trình tiếp nhận, lưu trữ, xử lý và phân tích trước khi trở thành thông tin có thể hỗ trợ hành động. Vì vậy, giá trị cốt lõi của Big Data không nằm ở chữ “Big”, mà nằm ở khả năng biến dữ liệu có quy mô và độ phức tạp cao thành tri thức có thể sử dụng.

GỬI Ý KIẾN BÌNH LUẬN
Bài xem nhiều
