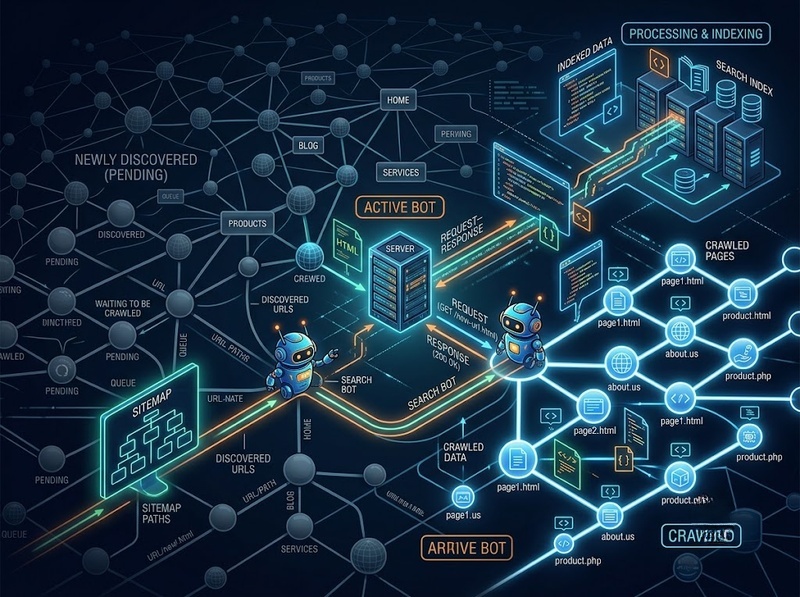
Điểm quan trọng là crawler không bắt đầu bằng việc “đọc toàn bộ Internet”. Trước tiên hệ thống phải biết một URL tồn tại, chẳng hạn thông qua liên kết trên một trang đã biết hoặc sitemap. Sau khi URL được phát hiện, Google mới quyết định có truy cập URL hay không, khi nào truy cập và tài nguyên nào cần tải. Vì vậy, có thể hình dung quá trình cơ bản theo chuỗi:
Phát hiện URL → Xác định khả năng truy cập → Gửi request → Nhận phản hồi → Thu thập tài nguyên → Render khi cần → Khám phá thêm URL
Chuỗi này cũng cho thấy một điểm dễ nhầm trong SEO: URL được phát hiện không đồng nghĩa URL đã được crawl; được crawl cũng không đồng nghĩa URL chắc chắn được index. Google không bảo đảm mọi URL được phát hiện đều sẽ được crawl hoặc index.
Bot tìm thấy URL trước khi crawl bằng cách nào?
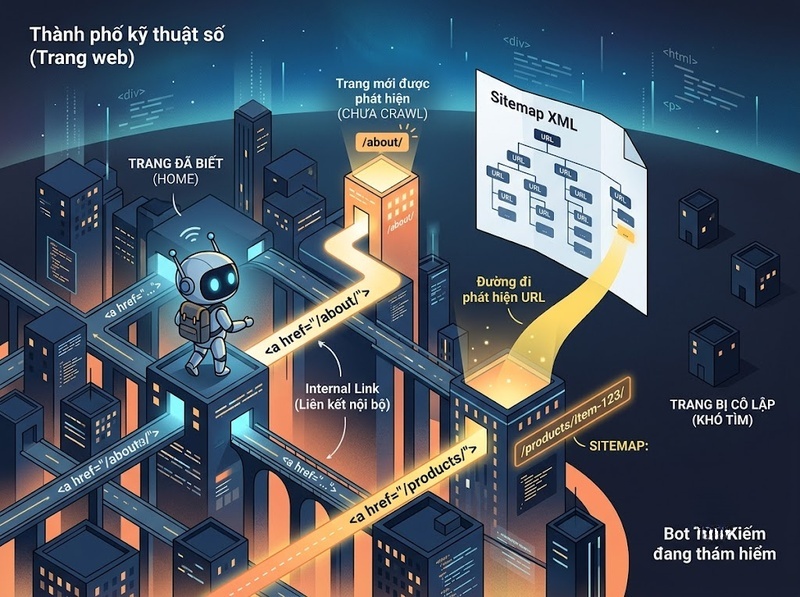
Muốn crawl một trang, crawler trước hết phải biết URL của trang đó. Google gọi bước này là URL discovery. Do không tồn tại một danh bạ trung tâm chứa tất cả trang web trên Internet, crawler phải liên tục phát hiện các URL mới và những URL đã thay đổi.
Hai nguồn khám phá URL đặc biệt quan trọng là link và sitemap.
Khi Googlebot truy cập một trang đã biết và tìm thấy liên kết dẫn đến URL khác, URL đích có thể được đưa vào tập URL mà hệ thống biết đến. Vì thế, một bài viết mới được liên kết từ trang danh mục, trang chủ hoặc bài viết liên quan có thể được crawler khám phá qua cấu trúc liên kết của website.
Đối với HTML, Google cho biết dạng liên kết mà hệ thống có thể crawl một cách đáng tin cậy là phần tử có thuộc tính href. Các thành phần chỉ hoạt động giống link thông qua sự kiện script nhưng không cung cấp URL theo cấu trúc phù hợp có thể khiến việc phát hiện URL trở nên khó khăn hơn.
Sitemap cung cấp một con đường khác. Website có thể liệt kê những URL muốn công cụ tìm kiếm biết đến trong sitemap và gửi sitemap cho Google. Sitemap đặc biệt hữu ích trong việc thông báo về URL mới hoặc URL đã cập nhật. Tuy nhiên, sitemap chỉ là một tín hiệu hỗ trợ khám phá và crawl; việc URL xuất hiện trong sitemap không phải cam kết rằng Googlebot sẽ crawl ngay hoặc Google sẽ index URL đó.
Vì vậy, xét riêng ở tầng khám phá, một URL có nhiều đường dẫn hợp lệ để bot tìm thấy thường dễ được đưa vào quá trình xử lý hơn một URL bị cô lập, không có internal link phù hợp và cũng không xuất hiện trong sitemap.
Phát hiện được URL mới chỉ trả lời câu hỏi “URL này tồn tại hay không?”. Bước tiếp theo là quyết định “có nên truy cập URL này và truy cập vào thời điểm nào?”.
Google cho biết Googlebot sử dụng một quy trình thuật toán để xác định website nào cần crawl, tần suất crawl và số lượng trang cần lấy từ mỗi website. Hệ thống cũng cố gắng tránh gửi request quá nhanh gây quá tải máy chủ. Nếu phản hồi từ server cho thấy website gặp vấn đề, chẳng hạn lỗi HTTP 500, hoạt động crawl có thể được giảm xuống.
Điều này giải thích vì sao crawl không nên được hình dung như một bot đi tuần tự từ URL thứ nhất đến URL cuối cùng của website. Trên thực tế, crawler phải lựa chọn giữa rất nhiều URL và cân đối nhu cầu thu thập với khả năng phục vụ của website.
Với những website lớn, khái niệm crawl budget trở nên đáng chú ý hơn. Google mô tả crawl budget theo sự kết hợp giữa khả năng/tốc độ crawl và nhu cầu crawl; nói đơn giản, đó là lượng URL Googlebot vừa có khả năng vừa muốn crawl. Những không gian URL giá trị thấp, URL trùng lặp hoặc số lượng lớn URL được tạo không cần thiết có thể khiến hoạt động crawl trở nên kém hiệu quả.
Tuy nhiên, crawl budget không nên được biến thành vấn đề mặc định cho mọi website. Với câu hỏi “crawl diễn ra như thế nào”, ý nghĩa quan trọng hơn là: crawler có cơ chế lựa chọn và lập lịch truy cập URL, chứ không crawl mọi URL ngay khi vừa phát hiện.
Khi Googlebot chuẩn bị crawl một website, một lớp kiểm soát quan trọng là robots.txt. Google hỗ trợ Robots Exclusion Protocol và crawler sẽ tải, phân tích file robots.txt để xác định những khu vực nào crawler được phép truy cập.
Vì vậy, nếu một URL được phát hiện nhưng bị rule phù hợp trong robots.txt chặn, việc phát hiện URL không tự động dẫn đến việc nội dung trang được crawl.
Đây cũng là điểm cần phân biệt giữa kiểm soát crawl và kiểm soát index.
robots.txt chủ yếu kiểm soát URL crawler được phép request. Nó không phải cơ chế phù hợp để bảo đảm một URL không xuất hiện trong Google Search. Ngược lại, noindex là chỉ thị dành cho indexing. Muốn Google nhìn thấy noindex, crawler phải được phép truy cập trang để đọc chỉ thị đó. Nếu URL bị robots.txt chặn, Googlebot có thể không nhìn thấy noindex trên trang.
Do đó:
· robots.txt tác động trực tiếp đến khả năng crawler truy cập URL
· noindex tác động đến việc nội dung có được đưa vào index hay không sau khi crawler có thể đọc chỉ thị
· URL discovery, crawling và indexing là các trạng thái liên quan nhưng không đồng nhất
Sự phân biệt này đặc biệt quan trọng khi phân tích một URL “không có trên Google”, bởi nguyên nhân có thể xuất hiện ở nhiều giai đoạn khác nhau.
Khi URL đã được phát hiện, được lựa chọn để crawl và crawler có quyền truy cập, Googlebot gửi request đến URL để lấy tài nguyên.
Server sau đó trả về HTTP response. Phản hồi này cho crawler biết URL đang hoạt động bình thường, chuyển hướng, không tồn tại hoặc server đang gặp sự cố. HTTP status vì vậy là một phần trực tiếp của quá trình crawler tương tác với website.
Google nêu ba yêu cầu kỹ thuật tối thiểu để một trang đủ điều kiện được index: Googlebot không bị chặn, trang hoạt động với phản hồi HTTP 200 (success) và trang có nội dung có thể index. Việc đáp ứng các yêu cầu này vẫn không bảo đảm trang chắc chắn được index.
Sau khi nhận nội dung, quá trình crawl không nhất thiết chỉ dừng ở việc tải HTML ban đầu. Google cho biết trong quá trình crawl, hệ thống có thể render trang và chạy JavaScript bằng phiên bản Chrome gần đây, tương tự cách trình duyệt xử lý trang. Điều này quan trọng với những website dựa vào JavaScript để đưa nội dung vào trang.
Có thể mô tả quá trình này ở mức khái niệm như sau:
1. Googlebot gửi request đến URL
2. Server trả về HTTP response
3. Crawler nhận HTML và các thông tin phản hồi
4. Các tài nguyên cần thiết cho việc hiểu/render trang có thể được xử lý
5. JavaScript có thể được chạy khi cần
6. Nội dung trang sau đó có thể được chuyển sang các bước xử lý tiếp theo
Điểm cần chú ý là crawl không chỉ phụ thuộc nội dung bạn nhìn thấy trên trình duyệt. Nếu crawler không truy cập được tài nguyên cần thiết, server phản hồi lỗi hoặc nội dung quan trọng chỉ xuất hiện theo cách crawler khó xử lý, kết quả crawler nhận được có thể khác với trải nghiệm của người dùng.
Crawl không phải quá trình kết thúc tại một URL riêng lẻ. Một trang được crawl có thể trở thành nguồn discovery cho những URL khác.
Ví dụ, giả sử website có cấu trúc:
Trang chủ → Danh mục SEO → Bài viết Crawl SEO → Bài viết Indexing
Khi crawler đã biết trang chủ, nó có thể tìm liên kết đến danh mục. Khi crawl danh mục, nó có thể phát hiện bài viết về Crawl SEO. Từ bài viết đó, một internal link khác lại có thể giúp crawler phát hiện bài viết về indexing.
Do đó, crawling có đặc tính lan truyền qua cấu trúc liên kết: URL đã biết giúp phát hiện URL chưa biết, URL mới được crawl lại có thể tạo thêm đường khám phá tiếp theo.
Google xác nhận links được sử dụng để tìm các trang mới cần crawl. Google cũng khuyến nghị sử dụng các liên kết HTML có thể crawl để giúp hệ thống tìm thấy những trang khác trên website.
Đây là lý do internal link không chỉ có ý nghĩa điều hướng cho người dùng. Ở góc độ crawl, nó còn tạo ra những đường mà crawler có thể theo để phát hiện cấu trúc URL của website.
Tuy vậy, có link đến URL vẫn không tạo ra bảo đảm URL sẽ được crawl ngay. Link hỗ trợ discovery; còn thời điểm và mức độ crawl vẫn phụ thuộc vào quyết định của hệ thống crawler.
Một trong những nhầm lẫn phổ biến nhất là coi “Google đã crawl” đồng nghĩa với “Google đã index”.
Hai trạng thái này không giống nhau.
Google mô tả crawling là giai đoạn crawler tải nội dung từ những trang được tìm thấy trên Internet. Indexing là giai đoạn tiếp theo, khi Google phân tích nội dung, hình ảnh, video và các thành phần quan trọng của trang để hiểu và lưu thông tin phù hợp vào Google index.
Do đó, một URL có thể đi qua chuỗi trạng thái:
Discovered → Crawled → Processed/Indexed → Có khả năng được phục vụ trong kết quả tìm kiếm
Nhưng không phải URL nào cũng đi hết chuỗi.
Một URL có thể được phát hiện nhưng chưa crawl. Một trang có thể được crawl nhưng không được index. Và một trang đã index cũng không mặc nhiên xuất hiện cho mọi truy vấn tìm kiếm.
Điều này tạo ra một boundary quan trọng khi phân tích SEO:
Crawl trả lời chủ yếu câu hỏi “bot có thể tìm và lấy nội dung hay không”; index trả lời câu hỏi “hệ thống có xử lý và lưu nội dung vào chỉ mục hay không”.
Vì vậy, khi một trang không xuất hiện trên Google, việc chỉ kiểm tra “bot có crawl không?” chưa đủ để kết luận vấn đề nằm ở đâu.
Nếu một URL mới không được crawl trong khoảng thời gian hợp lý, Google chỉ ra một số nhóm nguyên nhân đáng kiểm tra: hệ thống chưa biết URL, nội dung bị chặn, website gặp giới hạn về khả năng phục vụ request hoặc hoạt động crawl đang bị giới hạn bởi nguồn lực/crawl budget.
Ở cấp độ website, những vấn đề thường liên quan trực tiếp đến quá trình crawl gồm:
· URL không có đường discovery rõ ràng từ internal link hoặc sitemap
· robots.txt ngăn crawler truy cập
· Server hoặc network gặp lỗi khi Googlebot request
· Website tạo quá nhiều URL ít giá trị hoặc URL trùng lặp khiến crawl kém hiệu quả
· Liên kết được triển khai theo cách crawler không thể trích xuất URL một cách đáng tin cậy
· Nội dung phụ thuộc vào tài nguyên hoặc JavaScript mà crawler không thể truy cập/xử lý phù hợp
Trong thực tế, cách phân tích nên bám theo chính chuỗi hoạt động của crawler thay vì kiểm tra ngẫu nhiên từng yếu tố.
Nếu URL chưa được Google biết đến, vấn đề nằm ở discovery. Nếu URL đã được biết nhưng crawler không thể request, cần kiểm tra access, robots.txt, server và network. Nếu crawler truy cập được nhưng nội dung không được xử lý như mong muốn, cần xem response, tài nguyên và rendering. Nếu trang đã crawl nhưng chưa index, lúc đó vấn đề đã chuyển sang giai đoạn khác và không nên tiếp tục gọi chung là “lỗi crawl”.
Crawl SEO về bản chất là quá trình công cụ tìm kiếm tìm ra URL, quyết định truy cập, request tài nguyên và thu thập nội dung, đồng thời tiếp tục phát hiện các URL khác thông qua những tài nguyên đã crawl.
Với Google, quá trình có thể được hiểu theo logic: URL discovery → crawl selection → access control → HTTP request/response → resource fetching và rendering → tiếp tục URL discovery. Sau đó nội dung mới có thể đi sang giai đoạn indexing.
Hiểu đúng chuỗi này giúp tách biệt ba vấn đề thường bị gộp chung: bot chưa biết URL, bot biết nhưng chưa/không thể crawl, và bot đã crawl nhưng URL chưa được index. Đây là nền tảng để xác định đúng vị trí xảy ra vấn đề thay vì mặc định mọi trang không xuất hiện trên Google đều là lỗi crawling.